先确认要点再花钱
成片贵且改不了,所以调用模型前,系统先写出一页视频简报,把讲什么、给谁看、必须出现什么、不能说什么、画面怎么表现产品摆给你确认。你只需看取舍、点确认,确认了才开始花钱。
- 视频简报先定讲哪几条
- 亮点卡只看取舍点确认
- 确认了才开始花钱
做视频时,麻烦常在拼、改和持续发。
剧本、分镜、配音、剪辑都要自己拼。
换一家就要重新讲一遍,沟通成本高。
没确认要点就开拍,容易返工。
一周至少三五条,小团队拍不过来。
从一句需求到成片,先确认要点,再按工序完成并自检。
成片贵且改不了,所以调用模型前,系统先写出一页视频简报,把讲什么、给谁看、必须出现什么、不能说什么、画面怎么表现产品摆给你确认。你只需看取舍、点确认,确认了才开始花钱。
你说一句需求,引擎自己完成创意、剧本、分镜、画面、配音、音效、配乐、字幕、剪辑和审片。它内置在立言里,负责视频这一环,交回一条可以直接看的成片。中途失败可以从已完成的工序继续,不重复花钱。
每道工序都有自检;不合格时,引擎会找到真正出问题的那一道工序回去重做,而不是在最后一步硬凑。判断交给模型,规矩交给代码:时长是否超、引用是否对得上、预算是否够由代码硬性检查,不合规就打回。开拍前让一位没读过剧本的观众复述故事,看不懂就退回重写。引擎接入多家生图、生视频、配音模型,弱项经过实测登记;设计分镜时,把风险花在最重要的镜头上。每一次决定、每一次返工都有记录。
同一个人物在不同镜头里保持同一张脸、同一身打扮;上传一张合照,引擎能自动认出照片里的每一个人,分别作为片中角色。多人同场时按人物分别锁定形象,不会张冠李戴;同一场景先定场景底图,后续镜头从它派生,画面不跳。镜头之间用首尾画面衔接动作,减少硬切带来的凌乱感。
植入、形象、主推三种带货方式规定卖点出现位置,不会把软广拍成硬广。配音按角色和情绪匹配多种音色,人物说话时嘴型与台词对齐;音效根据画面配脚步、碰撞这类动作声;配乐从曲库里按场景情绪挑选。字幕与片尾卡自动排品牌名、口号、行动号召和联系方式,片尾卡由程序排版,不让 AI 画。
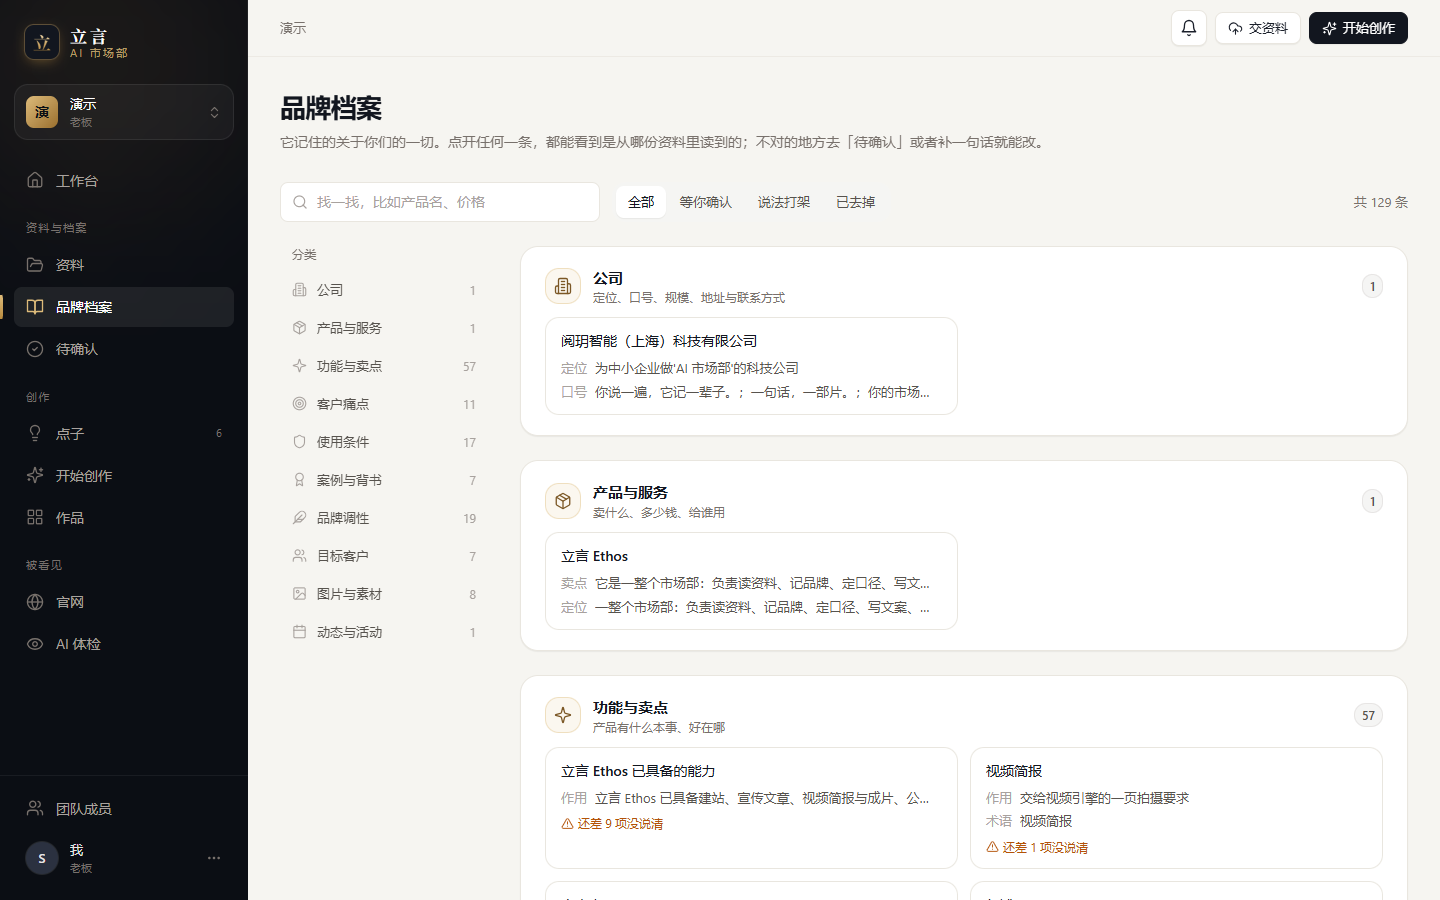
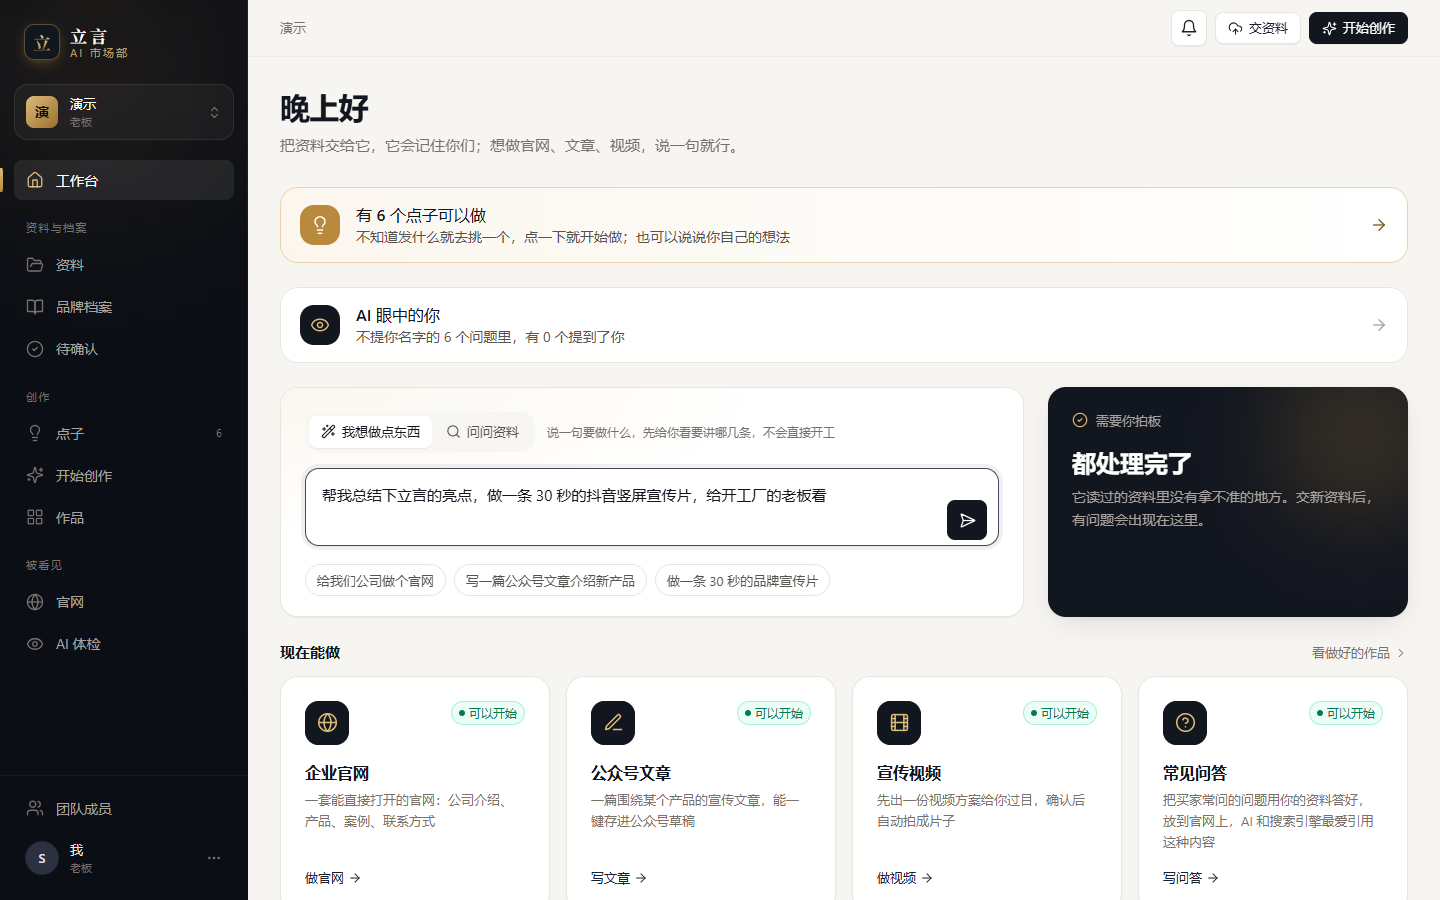
立言先从品牌信息库里取数,写出一页视频简报:讲哪几条、给谁看、不能说什么、画面里怎么认出产品、片尾放什么。因为简报只用库里有出处的信息,所以片子里的卖点和数字都能追溯到原始资料。成片落回立言的产出列表里。
32.3秒
品牌宣传片九道工序通过
30秒品牌片,真实模型出片,阅玥内部实测。
16
部片子走完九道工序
横屏竖屏都有,时长从30秒到8分钟。
30.1秒
竖屏硬广成片
9:16竖屏,真实模型出片,终审零问题。
112秒
品牌形象片成片
2分钟品牌形象片,16:9横屏,终审通过。
双人对白,16:9横屏,对白口型配乐齐全。